- La RTX 3090 puede multiplicar por 4,6 la generación de texto con optimizaciones de inferencia y decodificación especulativa.
- GPU Unlock libera parte del rendimiento de los Tensor Cores en Linux, con mejoras de hasta el 80 % y el 94 % en BF16 y TF32 sobre la RTX 3090 Ti.
- La VRAM y el ancho de banda siguen siendo el principal límite para generar tokens, aunque el procesamiento de prompts también mejora.
- Estas técnicas no aumentan los FPS en juegos ni DLSS y requieren perfiles técnicos, compatibilidad concreta y asumir limitaciones.
La Nvidia GeForce RTX 3090, una tarjeta de la generación Ampere que se popularizó por su enfoque gaming, está encontrando un segundo uso bastante interesante en tareas de inteligencia artificial. Varios desarrollos comunitarios están mostrando que el software puede cambiar de forma notable la experiencia sin tener que sustituir la GPU por un modelo profesional.
No se trata de un único truco milagroso ni de un cambio de hardware. Las pruebas que se han conocido combinan optimizaciones del motor de inferencia, herramientas de desbloqueo en Linux y ajustes que aprovechan mejor los Tensor Cores. Eso sí, conviene separar cada técnica y mirar con calma sus límites, porque no todas sirven para lo mismo.
Un caso llamativo en la RTX 3090: 4,6 veces más generación de texto
Uno de los ejemplos más comentados ha sido el de un desarrollador que logró multiplicar por 4,6 la velocidad de generación de texto en una RTX 3090 de 24 GB. El modelo utilizado fue Qwen3.8-27B y el rendimiento pasó de unos 82 tokens por segundo a 382 tokens por segundo, sin cambiar la tarjeta ni modificar el modelo de lenguaje.
El punto de partida es conocido: en la generación de texto con IA, la memoria y el ancho de banda suelen marcar el ritmo más que la potencia de cálculo pura. Para cada token, la GPU tiene que sacar pesos del modelo desde la VRAM, y el procesador gráfico pasa tiempo esperando datos. El caso reportado se apoyó en decodificación especulativa y en un sistema que busca secuencias repetidas para reutilizarlas, validando después bloques completos con el modelo principal.
Ese enfoque permite proponer varios tokens seguidos y comprobarlos en una sola pasada, de modo que la precisión final queda en manos del modelo grande. También se habla de una ventana de contexto ampliada hasta casi 139.000 tokens y de una velocidad de 133 tokens por segundo en conversaciones normales. Ahora bien, la lectura inicial de documentos largos puede requerir más tiempo y la verificación extendida consume más memoria de contexto.
GPU Unlock: Tensor Cores con menos freno en Linux
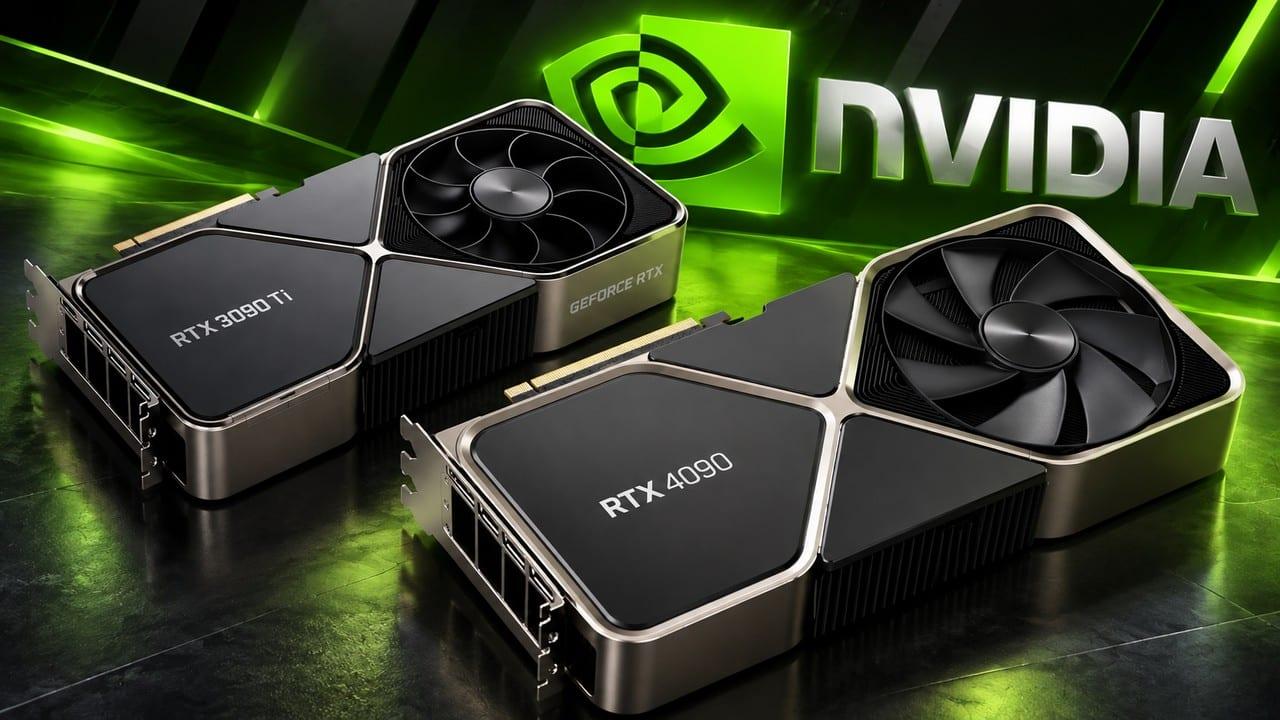
En paralelo, el proyecto de código abierto GPU Unlock ha llamado la atención por su forma de atacar una limitación distinta. Desarrollado por Zagitta en GitHub, utiliza un módulo del núcleo de Linux que se ejecuta antes de cargar el controlador oficial y aplica un reinicio a nivel de función. La idea es quitar frenos artificiales en los Tensor Cores de las RTX 30 sin flashear el VBIOS ni instalar controladores modificados de forma permanente.
Las cifras publicadas se centran sobre todo en la RTX 3090 Ti, no en la RTX 3090 a secas, y ahí conviene no mezclar modelos. En esa variante se han documentado saltos de aproximadamente 87,5 a 157 TFLOPS en BF16 y de 42,6 a 82,6 TFLOPS en TF32, lo que supone mejoras cercanas al 80 % y al 94 % en esas operaciones. Son datos de laboratorio y de pruebas concretas, no una promesa de que cualquier programa vaya a duplicar su velocidad.
En cargas reales de inteligencia artificial, las pruebas comunitarias apuntan a un crecimiento de alrededor de un tercio en el procesamiento de prompts con vLLM, mientras que la generación de tokens sigue muy condicionada por la VRAM. También se han visto mejoras en herramientas de generación de imágenes, aunque no conviene extrapolar esos resultados a todos los equipos ni a todos los flujos de trabajo. La compatibilidad se orienta a chips GA102, GA103, GA104 y GA106, y por ahora el método está ligado a Linux.
Diferencias entre las dos vías y límites prácticos
Las dos historias no son la misma cosa. La optimización de inferencia del caso de la RTX 3090 busca acelerar la decodificación de texto con técnicas como la decodificación especulativa, mientras que GPU Unlock trata de liberar capacidad de cálculo en los Tensor Cores. No compiten entre sí y tampoco deben presentarse como una solución única, porque atacan cuellos de botella diferentes.
GPU Unlock no aumenta el ancho de banda de la memoria ni añade núcleos CUDA. Por eso su impacto en videojuegos tradicionales o en DLSS es prácticamente nulo, ya que esos usos no dependen de los modos de acumulación que se desbloquean. Para alguien con una RTX 3090 en España o Europa, la conclusión práctica es que hay margen para exprimir la tarjeta en IA, pero hace falta perfil técnico, Linux y asumir ciertas limitaciones.
Todo apunta a que la RTX 3090 y su variante Ti siguen teniendo recorrido en inteligencia artificial gracias a la comunidad, aunque los resultados dependen mucho del modelo, del software y del tipo de tarea. El software marca diferencia, pero no hace magia: la VRAM, el ancho de banda y la compatibilidad siguen siendo factores decisivos para saber qué se puede esperar en cada caso.